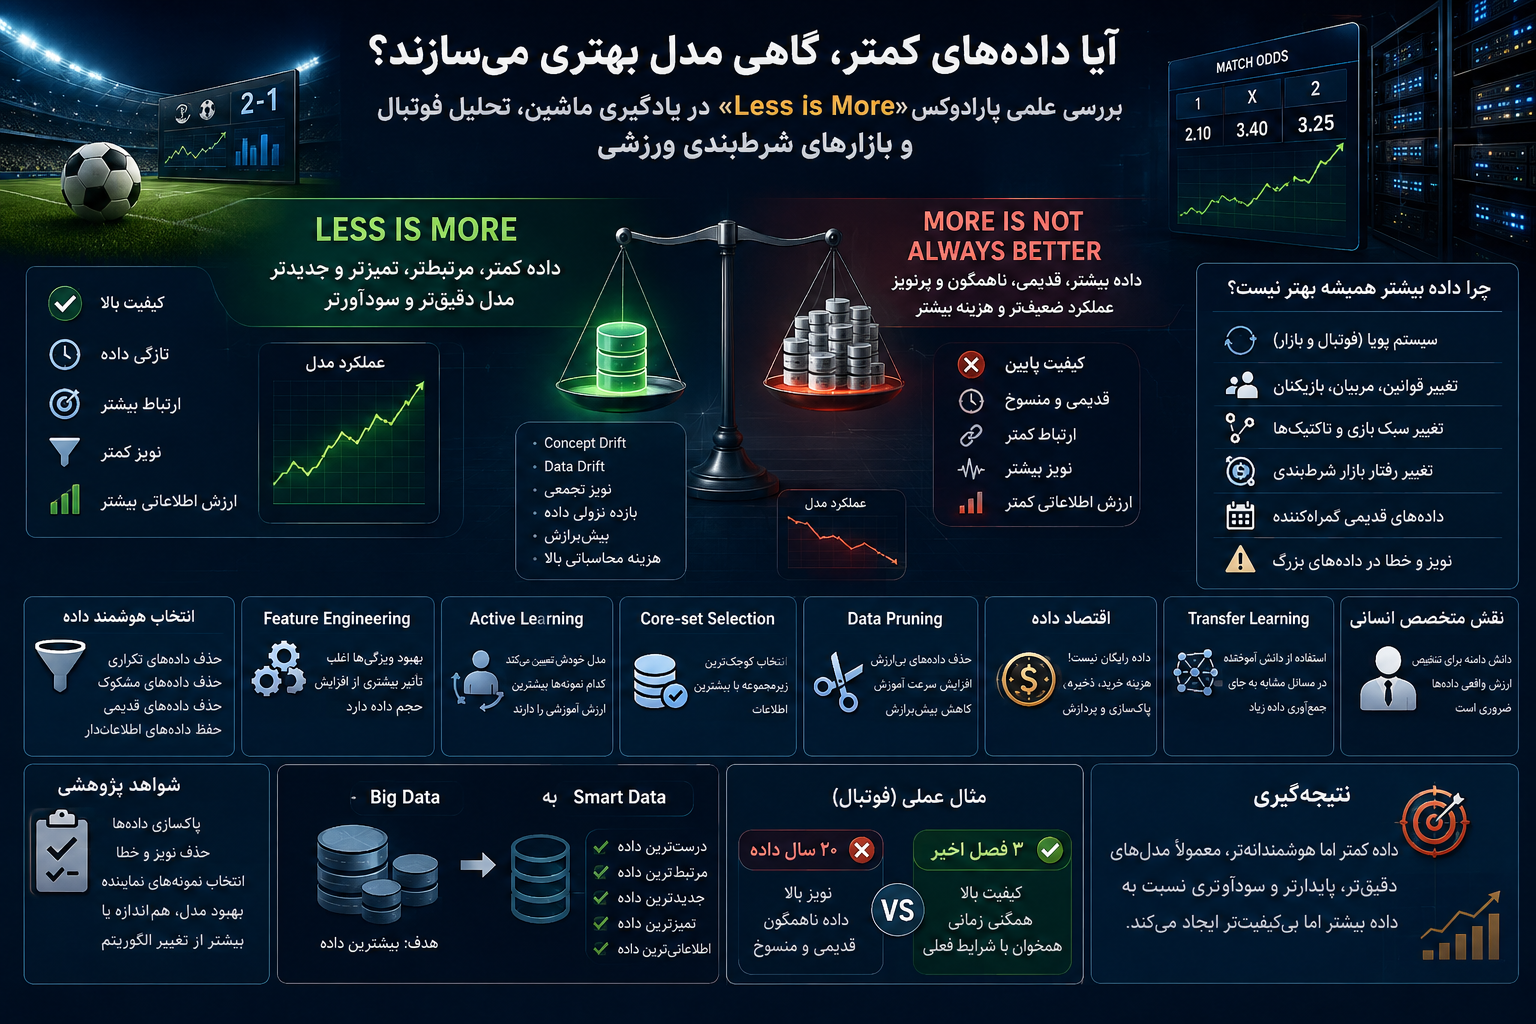
بررسی علمی پارادوکس «Less is More»در یادگیری ماشین، تحلیل فوتبال و بازارهای شرطبندی ورزشی
یکی از رایجترین باورها در عصر کلانداده (Big Data) این است که «هرچه داده بیشتر باشد، مدل بهتر خواهد بود». این تصور، که تا حدی از موفقیت شرکتهایی مانند گوگل، متا و آمازون الهام گرفته، باعث شده بسیاری از تحلیلگران ورزشی و پژوهشگران هوش مصنوعی تلاش کنند تا بیشترین حجم ممکن از دادههای مسابقات، بازیکنان و بازارهای شرطبندی را جمعآوری کنند.
با این حال، تحقیقات چند دهه اخیر در آمار، اقتصادسنجی، نظریه یادگیری آماری و یادگیری ماشین نشان دادهاند که این گزاره همیشه صحیح نیست. در بسیاری از مسائل واقعی، بهویژه در پیشبینی مسابقات فوتبال، افزایش حجم داده بدون توجه به کیفیت، ارتباط، همگنی زمانی و ساختار داده میتواند نه تنها سودمند نباشد، بلکه عملکرد مدل را نیز کاهش دهد.
این پدیده که گاهی با عنوان Less is More شناخته میشود، بیان میکند که داده کمتر اما مرتبطتر، تمیزتر و جدیدتر ممکن است نسبت به داده بسیار زیاد اما ناهمگون، قدیمی یا پرنویز، مدلهای دقیقتر و سودآورتری ایجاد کند.
۱. پارادوکس «داده بیشتر»
در نگاه اول، افزایش داده باید باعث کاهش خطای آماری شود.
زیرا:
نمونه بزرگتر
واریانس کمتر
تخمین پایدارتر
خواهد شد.
اما این نتیجه تنها زمانی برقرار است که دادهها:
مستقل باشند.
همتوزیع باشند (IID).
دارای کیفیت مناسب باشند.
از همان فرآیند تولید داده آمده باشند.
در فوتبال، این فرضها معمولاً برقرار نیستند.
۲. چرا داده بیشتر همیشه بهتر نیست؟
هر مشاهده جدید الزاماً اطلاعات جدید اضافه نمیکند.
ممکن است تنها:
نویز بیشتری وارد کند.
روابط قدیمی را حفظ کند.
الگوهای منسوخ را تقویت کند.
مدل را از شرایط فعلی دور کند.
بنابراین ارزش اطلاعاتی هر داده، مهمتر از تعداد آن است.
۳. دیدگاه نظریه اطلاعات
بر اساس نظریه اطلاعات Claude Shannon، آنچه اهمیت دارد اطلاعات جدید (Information Gain) است، نه صرفاً حجم داده.
اگر هزار مسابقه جدید همان الگوهای قبلی را تکرار کنند، اطلاعات بسیار کمی به مدل اضافه میشود.
اما ده مسابقه که یک تغییر تاکتیکی یا قانونی مهم را منعکس کنند، ممکن است ارزش اطلاعاتی بسیار بیشتری داشته باشند.
۴. فوتبال؛ یک سیستم غیرایستا
برخلاف بسیاری از مسائل فیزیکی، فوتبال یک سیستم پویا است.
موارد زیر دائماً تغییر میکنند:
سبک بازی تیمها
مربیان
کیفیت بازیکنان
قوانین مسابقات
فناوری VAR
فشردگی تقویم
رفتار بازار شرطبندی
بنابراین دادههای بسیار قدیمی ممکن است دیگر نماینده واقعیت امروز نباشند.
۵. Concept Drift
یکی از مهمترین دلایل شکست مدلهای مبتنی بر دادههای بسیار زیاد، Concept Drift است.
Concept Drift
یعنی:
رابطه میان ویژگیها و نتیجه مسابقه در طول زمان تغییر کرده است.
در این شرایط، اضافه کردن دادههای قدیمی ممکن است مدل را گمراه کند.
۶. Data Drift
گاهی حتی توزیع دادهها نیز تغییر میکند.
مثلاً:
میانگین xG لیگ افزایش یافته است.
سرعت بازی بیشتر شده است.
تعداد تعویضها تغییر کرده است.
اگر مدل هنوز از دادههای ده سال قبل استفاده کند، بخشی از آموزش آن به توزیعی تعلق دارد که دیگر وجود ندارد.
۷. مثال عملی
فرض کنید قصد پیشبینی لیگ برتر انگلیس فصل جاری را دارید.
دو گزینه دارید:
الف)
تمام دادههای ۲۰ سال گذشته.
ب)
سه فصل اخیر با کیفیت بالا.
در بسیاری از پژوهشها، گزینه دوم عملکرد بهتری دارد؛ زیرا بهتر با شرایط کنونی همخوانی دارد.
۸. نویز تجمعی
با افزایش حجم داده، همیشه اطلاعات افزایش نمییابد؛
گاهی تنها نویز جمع میشود.
نمونههایی از نویز:
اشتباهات ثبت داده
تغییر کیفیت اپراتورها
تغییر استانداردهای آماری
مسابقات غیرعادی
شرایط آبوهوایی نادر
هرچه داده قدیمیتر باشد، احتمال ناسازگاری آن نیز بیشتر است.
۹. قانون بازده نزولی داده
مشابه اقتصاد، داده نیز از قانون بازده نزولی (Diminishing Returns) پیروی میکند.
دادههای اولیه معمولاً بیشترین بهبود را ایجاد میکنند.
اما پس از یک نقطه، هر داده جدید بهبود بسیار اندکی ایجاد میکند و حتی ممکن است هزینه محاسباتی و ریسک بیشبرازش را افزایش دهد.
۱۰. کیفیت در برابر کمیت
فرض کنید دو مجموعه داده داریم:
مجموعه اول:
۵۰ هزار مسابقه
نویز بالا
داده ناقص
تغییر قوانین
برچسبهای ناسازگار
مجموعه دوم:
۸ هزار مسابقه
کیفیت بسیار بالا
ویژگیهای دقیق
برچسبهای معتبر
همگنی زمانی
در بسیاری از کاربردهای واقعی، مجموعه دوم نتایج بهتری ایجاد میکند.
[7/27/2026 8:48 PM] Alfredo: ۱۱. Feature Engineering
بهتر از داده بیشتر
مطالعات متعدد نشان دادهاند که:
بهبود ویژگیها (Feature Engineering)
اغلب تأثیر بیشتری از افزایش حجم داده دارد.
یک ویژگی جدید با اطلاعات بالا ممکن است از افزودن هزاران مسابقه قدیمی ارزشمندتر باشد.
۱۲. اثر بر بیشبرازش
ممکن است تصور شود داده بیشتر همیشه خطر Overfitting را کاهش میدهد.
این تنها زمانی درست است که دادهها از همان توزیع باشند.
اگر دادههای نامرتبط اضافه شوند، مدل ممکن است روابط اشتباه را نیز یاد بگیرد و در نتیجه تعمیم آن کاهش یابد.
۱۳. هزینه محاسباتی
دادههای بزرگتر به معنای:
حافظه بیشتر
زمان آموزش بیشتر
هزینه پردازش بیشتر
مصرف انرژی بیشتر
است.
اگر بهبود دقت ناچیز باشد، این هزینهها از نظر اقتصادی توجیهپذیر نیستند.
۱۴. انتخاب هوشمند داده
یکی از موضوعات مهم در یادگیری ماشین مدرن، Data-Centric AI است.
در این رویکرد، به جای جمعآوری بیپایان داده، تمرکز بر انتخاب دادههای ارزشمندتر است.
این شامل:
حذف دادههای تکراری
حذف دادههای مشکوک
حذف نمونههای قدیمی
حفظ نمونههای اطلاعات دار
میشود.
۱۵. Active Learning
در Active Learning،
مدل خودش تعیین میکند کدام نمونهها بیشترین ارزش آموزشی را دارند. در نتیجه،
به جای میلیونها داده، تنها هزاران نمونه مهم برچسبگذاری میشوند.
۱۶. Core-set Selection
در بسیاری از پروژههای بینایی ماشین و تحلیل ورزشی، از روشهای Core-set Selection استفاده میشود.
هدف:
انتخاب کوچکترین زیرمجموعهای است که بیشترین اطلاعات را حفظ کند.
۱۷. اقتصاد داده
داده رایگان نیست.
جمعآوری داده شامل هزینههای:
خرید داده
ذخیرهسازی
پاکسازی
پردازش
کنترل کیفیت
نگهداری
است.
بنابراین باید میان ارزش اطلاعاتی و هزینه اقتصادی تعادل برقرار شود.
۱۸. بازارهای شرطبندی ورزشی
در شرطبندی حرفهای، دادههای بسیار قدیمی ممکن است حتی زیانآور باشند.
برای مثال:
بازارهای امروزی نسبت به ده سال پیش بسیار کاراتر شدهاند.
استفاده از ضرایب قدیمی ممکن است مدل را نسبت به ساختار فعلی بازار دچار خطا کند.
۱۹. نقش Data Pruning
امروزه بسیاری از تیمهای حرفهای شرط بندی به جای افزودن داده، اقدام به Data Pruning میکنند.
یعنی:
حذف دادههایی که دیگر ارزش اطلاعاتی ندارند.
این کار:
سرعت آموزش را افزایش میدهد.
خطر بیشبرازش را کاهش میدهد.
کیفیت مدل را بهبود میبخشد.
۲۰. یادگیری انتقالی (Transfer Learning)
گاهی به جای جمعآوری دادههای بسیار زیاد، از دانش آموختهشده در مسائل مشابه استفاده میشود.
این روش نشان میدهد که کیفیت دانش اولیه میتواند جایگزین بخشی از حجم داده شود.
۲۱. نقش متخصص انسانی
انتخاب اینکه کدام داده ارزش نگهداری دارد، اغلب نیازمند دانش دامنه است.
برای مثال:
یک تحلیلگر فوتبال میتواند تشخیص دهد که دادههای مربوط به قبل از تغییر قانون پنج تعویض، برای برخی مدلها ارزش کمتری دارند.
۲۲. شواهد پژوهشی
پژوهشهای حوزه یادگیری ماشین نشان دادهاند که:
پاکسازی دادهها
حذف نمونههای نویزی
حذف برچسبهای اشتباه
انتخاب زیرمجموعههای نماینده
اغلب بهبودی هماندازه یا حتی بیشتر از تغییر الگوریتم ایجاد میکنند.
این یافتهها پایه شکلگیری جنبش Data-Centric AI بودهاند.
۲۳. آینده؛ از Big Data به Smart Data
روند آینده از Big Data به سمت Smart Data است.
هدف دیگر «بیشترین داده» نیست، بلکه:
درستترین داده
مرتبطترین داده
جدیدترین داده
تمیزترین داده
اطلاعاتیترین داده
خواهد بود.
در تحلیل فوتبال و بازارهای شرطبندی ورزشی، مزیت رقابتی آینده احتمالاً نه از حجم عظیم داده، بلکه از توانایی انتخاب و مدیریت هوشمند داده حاصل خواهد شد.
این باور که «داده بیشتر همیشه مدل بهتری میسازد» در بسیاری از مسائل واقعی، بهویژه در فوتبال و بازارهای شرطبندی، نادرست است. کیفیت، تازگی، همگنی، ارتباط و ارزش اطلاعاتی دادهها معمولاً بسیار مهمتر از حجم آنها هستند. ورود دادههای قدیمی، پرنویز یا نامرتبط میتواند باعث کاهش دقت، افزایش هزینه محاسباتی و ایجاد سوگیری در مدل شود.
رویکردهای نوین علم داده نشان میدهند که موفقترین سیستمها الزاماً بزرگترین پایگاههای داده را ندارند؛ بلکه پایگاههایی را در اختیار دارند که با دقت انتخاب، پاکسازی و مدیریت شدهاند. در نهایت، در بسیاری از کاربردهای عملی، داده کمتر اما هوشمندانهتر میتواند نسبت به داده بیشتر اما بیکیفیتتر، مدلهای دقیقتر، پایدارتر و از نظر اقتصادی سودآورتری ایجاد کند.